
- 发布日期:2026-09-18 07:53 点击次数:69
(起首:机器之心)赌钱app下载
扩散讲话模子(Diffusion Language Models,DLM)一直以来都令谋划者颇感趣味,因为与必须按从左到右法例生成的自回顾模子(Autoregressive, AR)不同,DLM 能竣事并行生成,这在表面上不错竣事更快的生成速率,也能让模子基于前后文更好地建壮生谚语境。
但是,尽管自后劲浩大,DLM 的闇练仍然充满挑战,主要原因是它在 scaling 上的效用相对低于 AR 模子。举例,径直闇练 DLM 需要在有限的数据集上进行更屡次迭代,身手高出径直闇练的 AR 模子。此外,AR 模子还领有权贵的「先发上风」—— 包括练习的闇练基础门径、踏实的闇练配方以及平凡的从业者训戒蓄积。
为了克服这些难点,来自 Radical Numerics(一个新的 AI 初创)的谋划团队遴荐了另一条路:在现存自回顾模子的基础上进行改良,让它具备扩散讲话模子的智商。

他们刚刚发布的 RND1-Base(Radical Numerics Diffusion)是迄今为止范围最大的开源扩散讲话模子。其生成效果如下:
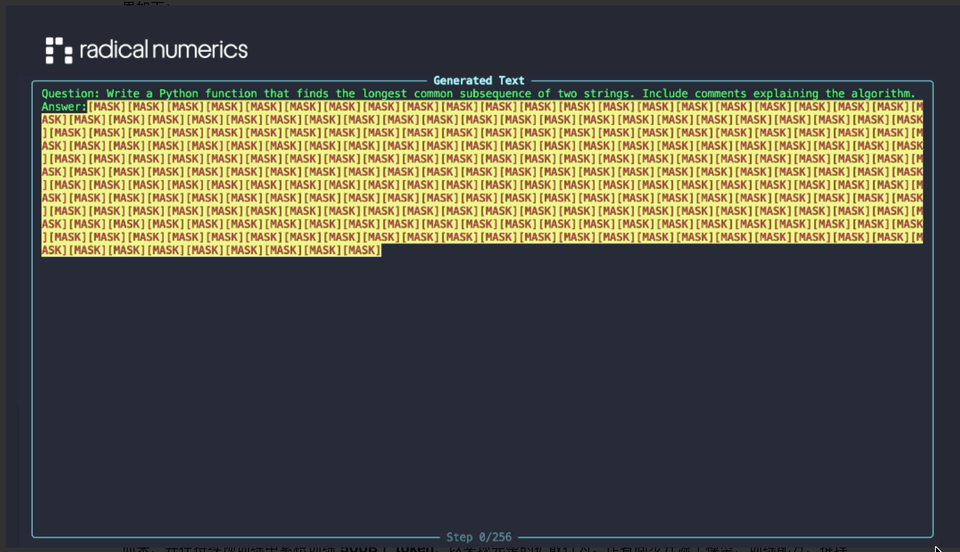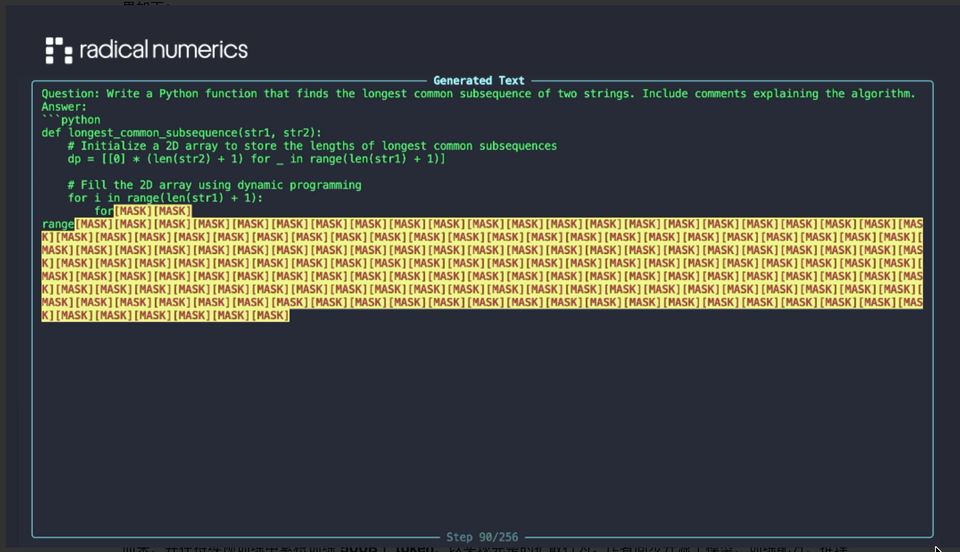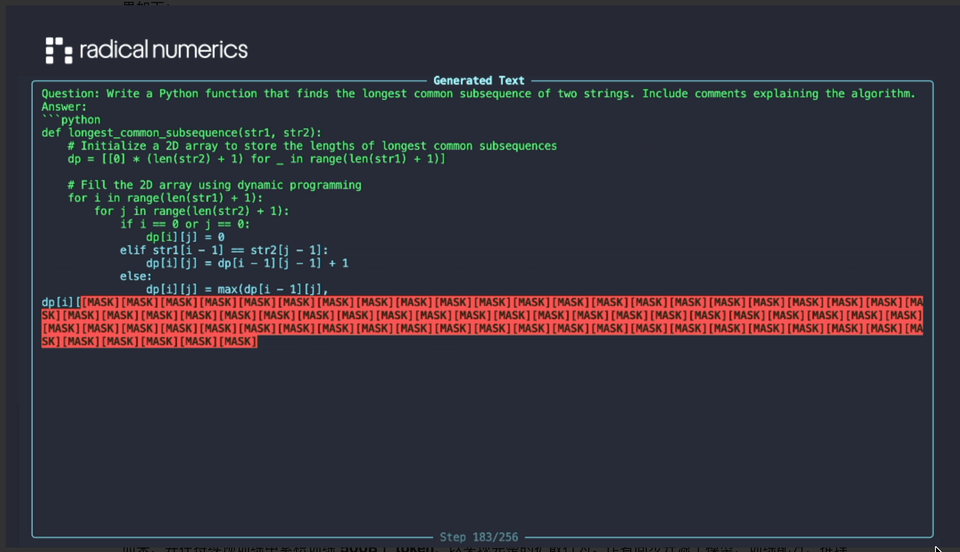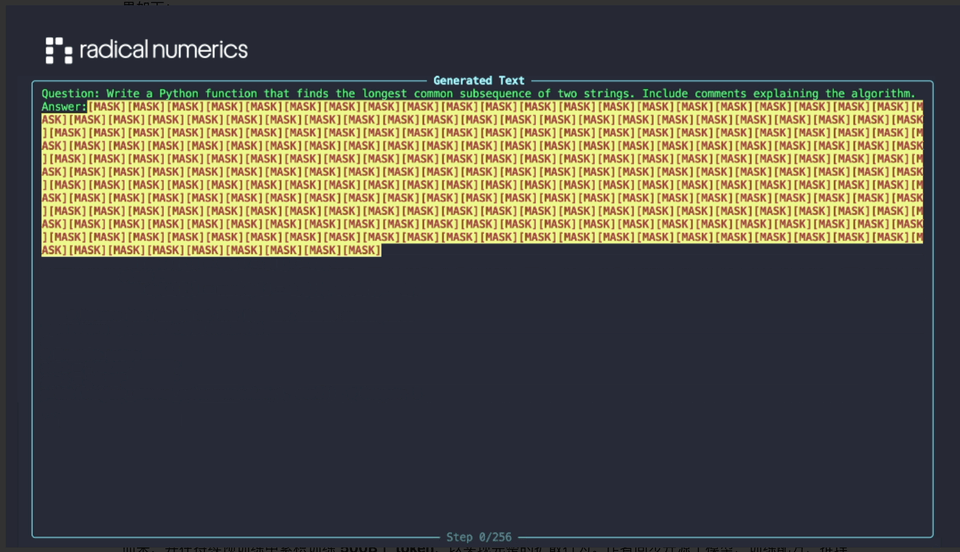
这是一个实验性的 30B 参数疏淡 MoE 模子,其中有 3B 激活参数,由一个预闇练的 AR 模子(Qwen3-30BA3B)革新而来,并在执续预闇练中累积闇练 500B 个 token,以竣事圆善的扩散作为。作家同步开源了模子、闇练配方、推理代码以及样例输出。

技艺答复:Training Diffusion Language Models at Scale using Autoregressive Models答复趋附:https://www.radicalnumerics.ai/assets/rnd1_report.pdf代码趋附:https://github.com/RadicalNumerics/RND1HuggingFace 趋附:https://huggingface.co/radicalnumerics/RND1-Base-0910
这项谋划的主要孝敬包括:
系统性谋划了大范围 A2D(Autoregressive-to-Diffusion)革新过程中的枢纽身分,如开动化计策、层级学习率和临界批大小。识别出大略竣事可推广性与踏实性的枢纽身分,并阐述当这些身分与练习的自回顾预闇练形态纠合时,通俗的技艺组合也能催生可推广的 DLM。推出了迄今为止最大的基础扩散讲话模子 RND1-30B,展示了将自回顾预闇练训戒科学化革新后可在多项基准测试中取得超卓阐扬。
具体来说,谋划者在推理(MMLU、ARC-C、RACE、BBH)、STEM(GSM8K)以及代码生成(MBPP)等通用基准测试中测试了 RND1。截至流露,它在扫数评测中均踏实高出现存 Dream-7B 和 LLaDA-8B,同期保执了其自回顾基础模子的强盛性能。

这些截至标明,将扩散讲话模子范围推广到 80 亿参数以上不仅可行,况且切实灵验。A2D 革新可能是闇练 DLM 更优的计策。RND1 亦然首个在此范围上奏效展示扩散模子闇练的开源形势。
不外,需要指出的是,谋划者并未将 RND1 与 Llada 系列的最新模子 ——LLaDA-MoE-7B-A1B 进行对比。从部分见地来看,RND1 并未高出 LLaDA-MoE-7B-A1B 的阐扬。两个模子哪个更强还需要进一步 PK。

通俗执续预闇练(SCP)
从一个自回顾检查点闇练扩散讲话模子,会引出两个中枢问题:
第一,如安在一个原来仅守旧因果介怀力(causal attention)的架构中引入双向高下文?
第二,如安在革新过程中保留 AR 模子从数万亿 token 预闇练中获取的讲话与事实学问?
早期谋划建议了多阶段复杂过程,举例介怀力掩码退火(attention mask annealing),通过迟缓减轻因果掩码竣事双向介怀力;或嫁接法(grafting),即系统性修改模子结构,用双向介怀力替换因果介怀力。
这些形态在小范围模子上灵验,但时时引入稀少联想遴荐(如掩码变化计策、退火 / 嫁接诊疗),难以踏实地本质至大范围。
相较之下,作家发现了一种更通俗的形态 —— 通俗执续预闇练(SCP),大略达到与这些复杂 A2D 革新过程止境的性能。
其配方极为径直:
从一个强盛的 AR 检查点首先;在开动化时将因果掩码替换为双向掩码;在掩码扩散方向下延续预闇练,并收受学习率预热。
通过层级学习率保留 AR 预闇练学问
A2D 革新靠近的主要风险之一是不幸性渐忘:模子可能在革新过程中丢失原有的事实学问。 既有谋划标明,Transformer 类讲话模子中的学问(尤其是事实相干)主要编码在 FFN/MLP 层中 。基于这一意识,他们在不同参数组间收受了分层学习率计策:
在革新时辰,介怀力层使用更高的学习率以便快速允洽双向高下文,而非介怀力层(如 MLP 与镶嵌层)使用较低学习率,以最猛进程保留 AR 预闇练学问。
A2D 革新在大 batch size 闇练下阐扬更佳
自回顾闇练与扩散闇练的一个隐微但枢纽的划分在于:每个批次提供的监督信号量不同。 在 AR 模子中,每个 token 都会参与损左筹备;而在扩散闇练中,唯独序列中被掩饰的位置会参与监督。在设施掩码扩散方向下,平均掩码比例约为 50%,也便是说唯唯一半的 token 参与学习。 这种较弱的学习信号意味着,用于 scale batch size 和学习率的设施自回顾启发式形态不一定适用于扩散闇练。
为更好建壮这少量,作家测度了临界批大小(Critical Batch Size, CBS)—— 即当数据并行度延续增大时,弃世立异收益首先递减的阈值。按照其他论文中的形态,他们通过分支闇练实验来实证信服该点。
从一个在 SCP 配方下已闇练 600 亿 token 的 40 亿参数模子检查点起程,作家启动了四个仅在全局批量大小上不同的并行闇练分支。他们诊疗学习率、保执优化器拓荒与权重衰减不变,并在 token 空间上对皆预热与衰减诊疗。每个分支再闇练稀少 50 亿 token。
实验截至标明,在 40 亿参数范围下,跟着批量增大,扩散弃世执续单调下落,直到约 800 万 token 仍有收益。换句话说,扩散讲话模子在执续预闇练阶段大略灵验左右更大的 batch size—— 这对大范围闇练是一个积极信号。

为什么要改良自回顾模子?
RND1 展示了如安在不推倒重来的情况下,高效探索新架构与新闇练范式。
这种效用体现了 Radical Numerics 核神思念的实质 —— 构建一个大略递归自我立异的自动化 AI 谋划平台,让 AI 系统匡助联想和优化下一代 AI。
通过自动化实验轮回,他们大略更快地遍历搜索空间,考据更斗胆的思法。RND1 恰是这一理念的首个具体效用之一。

Radical Numerics 的创举成员来自 DeepMind、Meta、Liquid、Stanford 等顶级机构,偏好夹杂架构、Hyena 和 Evo 等技艺。在一个酬酢媒体帖子中,公司创举东谈主之一 Michael Poli 阐发了他们的信念和愿景。

感趣味的读者不错查阅更多贵府了解该公司。
参考趋附:https://www.radicalnumerics.ai/blog/rnd1赌钱app下载